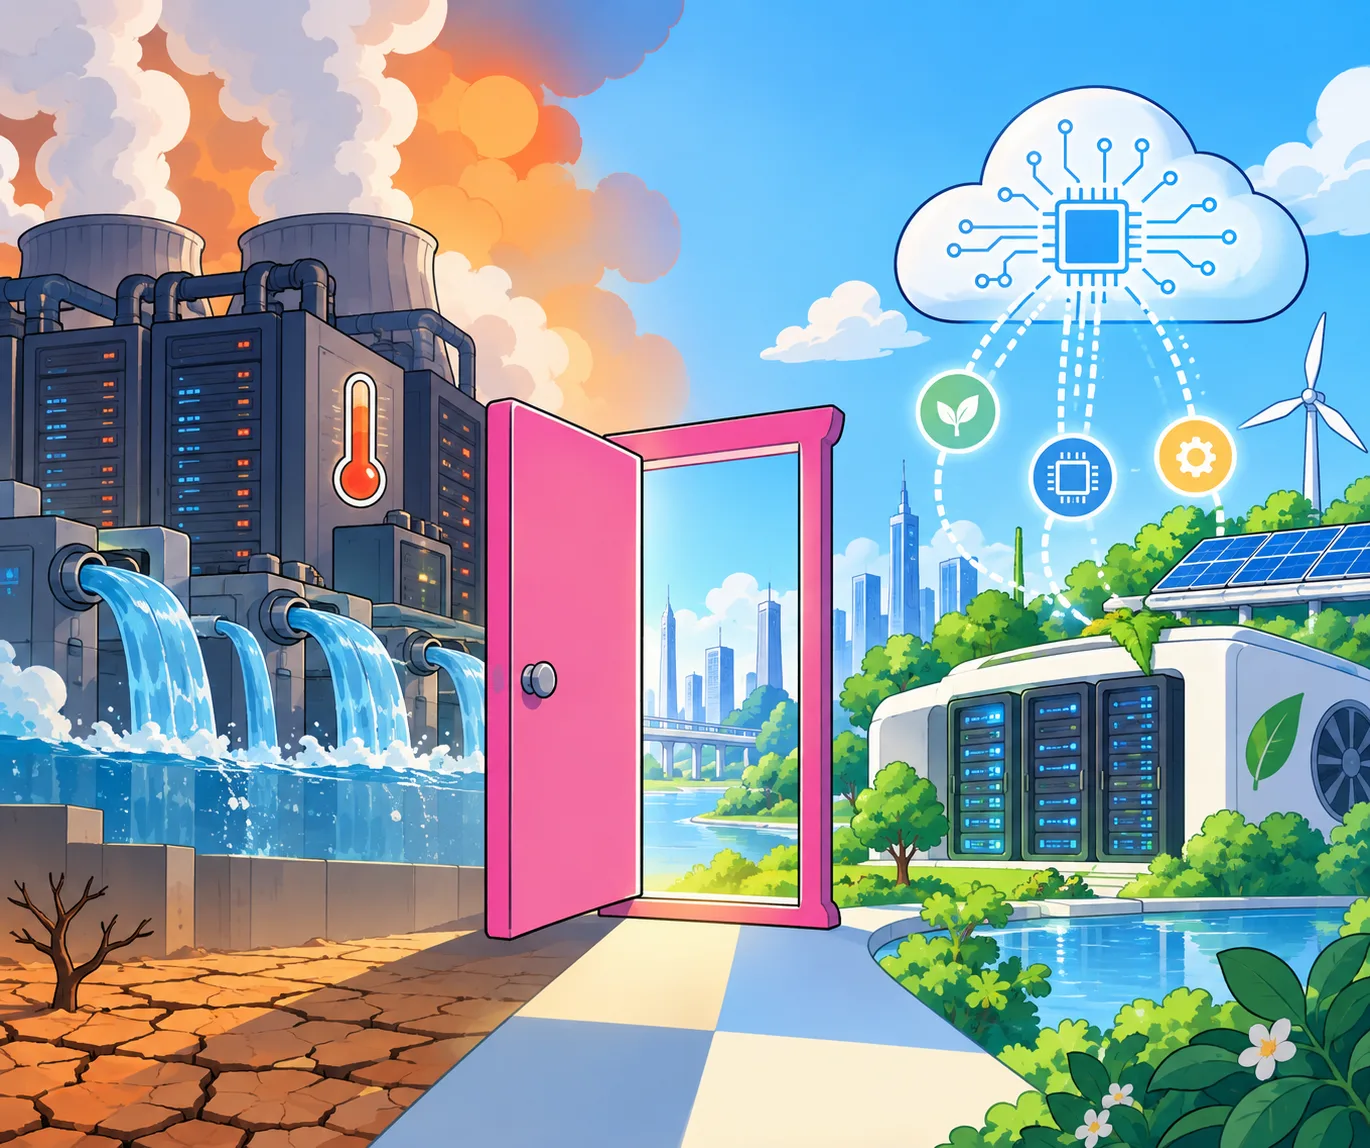
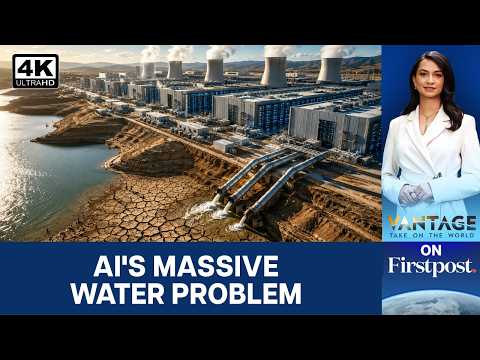
Semua orang tengah bising pasal AI yang makan elektrik, hasilkan haba, dan bagi tekanan pada sumber air untuk penyejukan pusat data.
Tapi mungkin kita tanya soalan yang salah.
Soalan sepatutnya bukan sekadar:
"Berapa banyak tenaga yang AI makan?"
Tapi juga:
"Kenapa kita guna AI compute yang mahal untuk tugasan yang memang tak pernah perlukannya?"
Bukan setiap tugasan perlukan model frontier.
Validation SKU yang ringkas tak perlukan LLM besar.
Workflow order processing yang berulang tak perlukan deep reasoning.
Business logic inventori yang dah kita tahu tak perlukan ribuan token setiap kali ia berjalan.
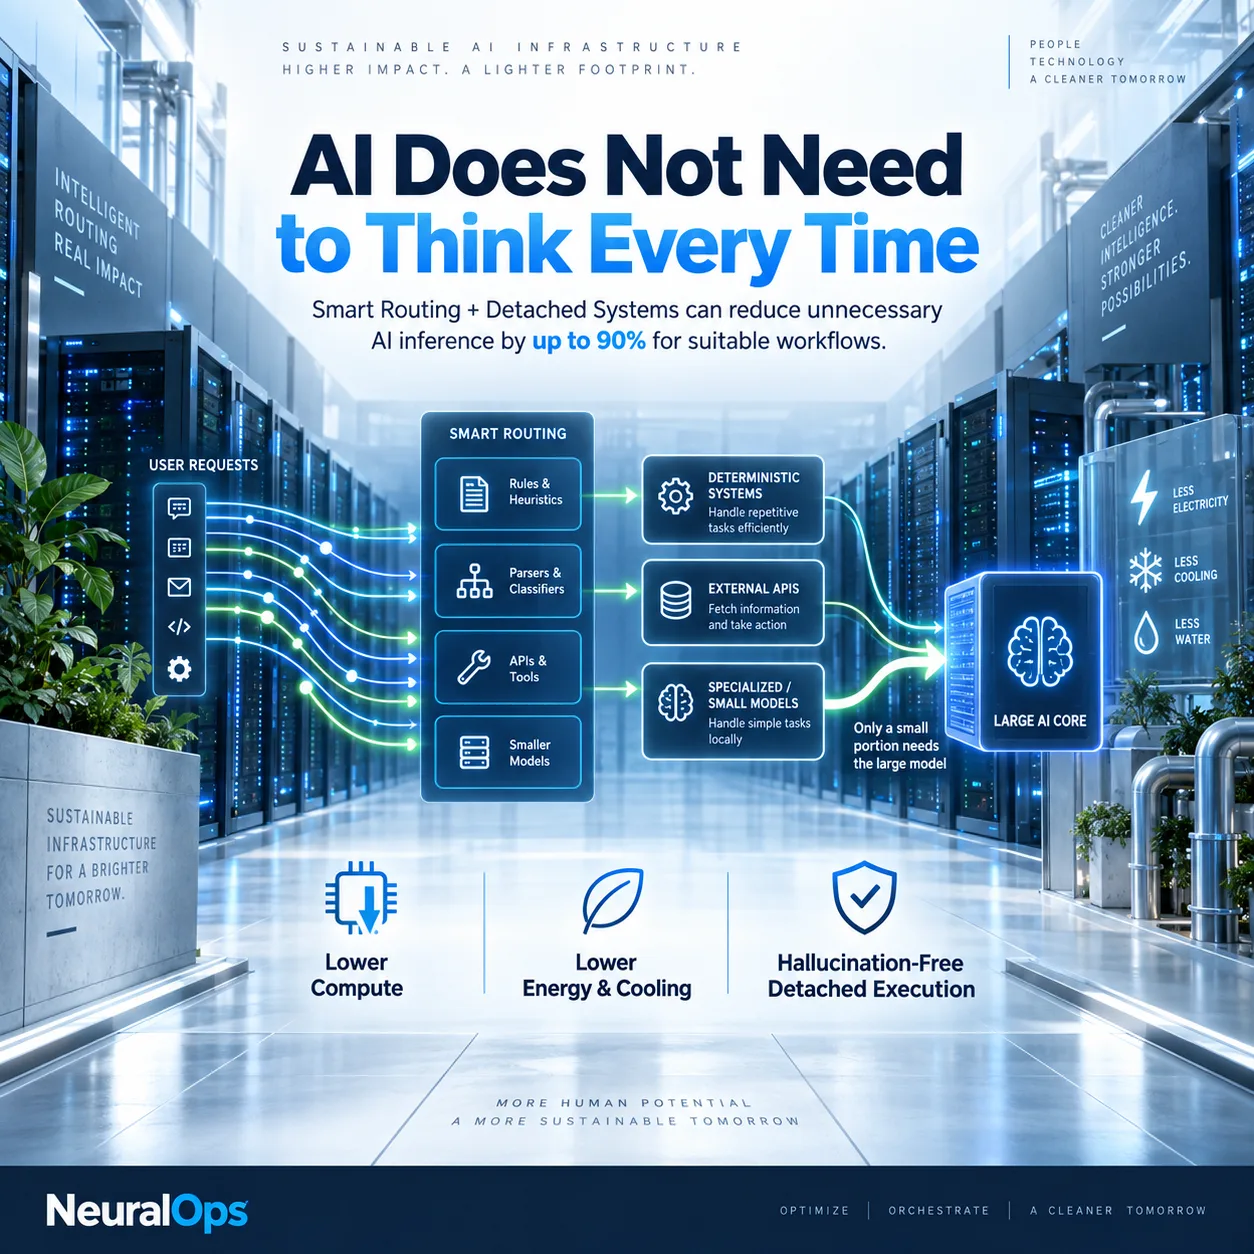
Inilah prinsip di sebalik kerja kami dengan NeuralOps:
Guna AI termaju hanya bila betul-betul perlu.
Route tugasan mudah ke sistem deterministic.
Guna model yang lebih kecil atau local bila sesuai.
Cache hasil yang boleh diguna semula.
Kurangkan context dan pemprosesan token yang tak perlu.
Escalate ke model berkuasa hanya untuk masalah yang betul-betul memerlukannya.
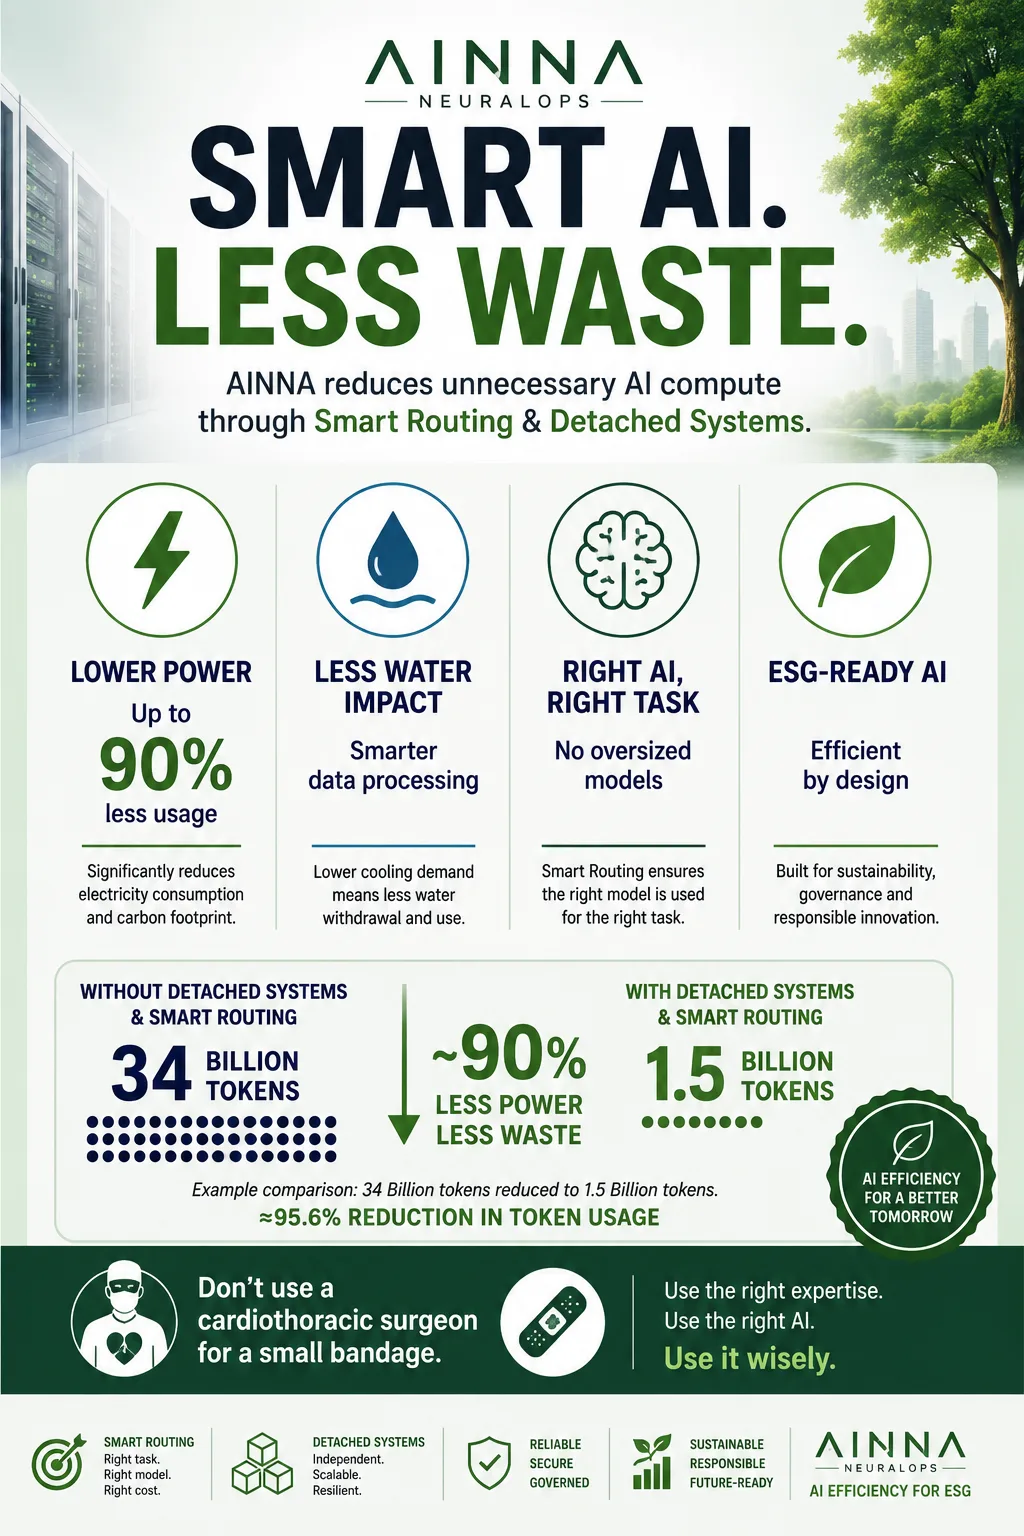
Kurang compute yang tak perlu bermakna kurang pemprosesan, kurang permintaan tenaga, dan kurang haba yang akhirnya kena diurus.
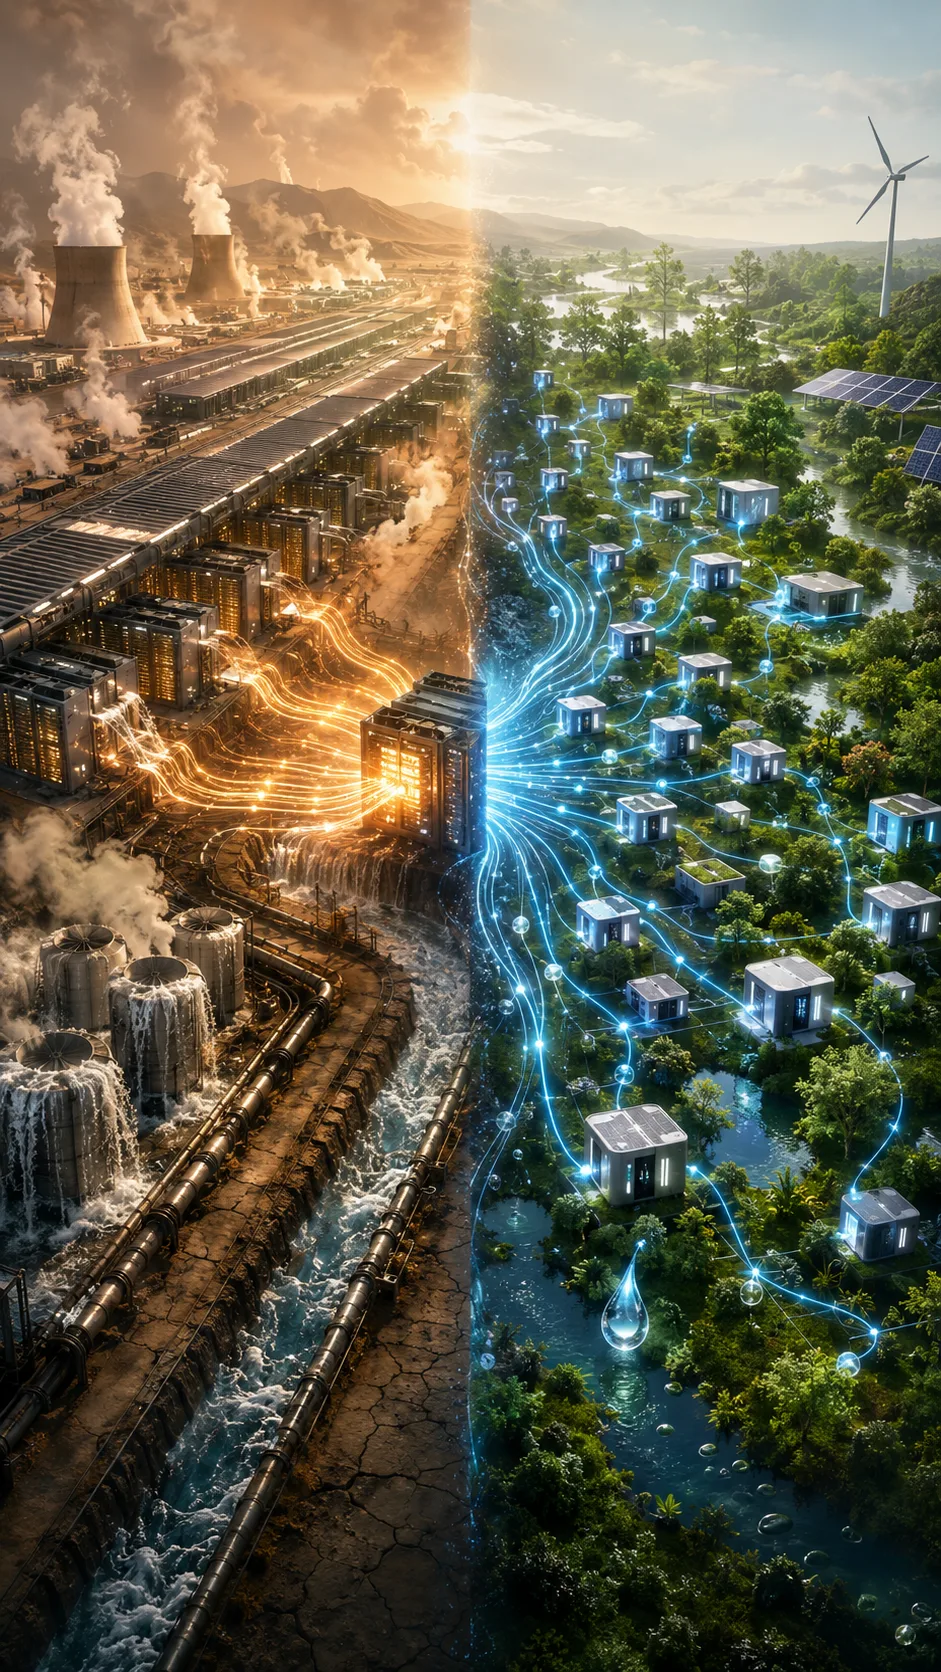
Masa depan AI yang mampan bukan sekadar pasal bina pusat data yang lebih hijau.
Ia juga pasal bina seni bina AI yang lebih pintar sebelum beban kerja itu sampai ke pusat data.
Kecekapan AI bukan sekadar isu infrastruktur.
Ia isu seni bina.
#ArtificialIntelligence #SustainableAI #GreenAI #NeuralOps #AIInfrastructure #DataCenter #EnergyEfficiency #ESG #AgenticAI #DigitalTransformation
Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. Email diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
الجزء المتعلق بـ هذا المقال جعلني أفكر مطولًا.
Still thinking about guna model yang lebih kecil.
Useful. We are dealing with validation SKU yang ringkas tak right now.
La explicación sobre este tema es clara y fácil de seguir.
Semua orang tengah bising pasal - itu dah ringkasan artikel ni.