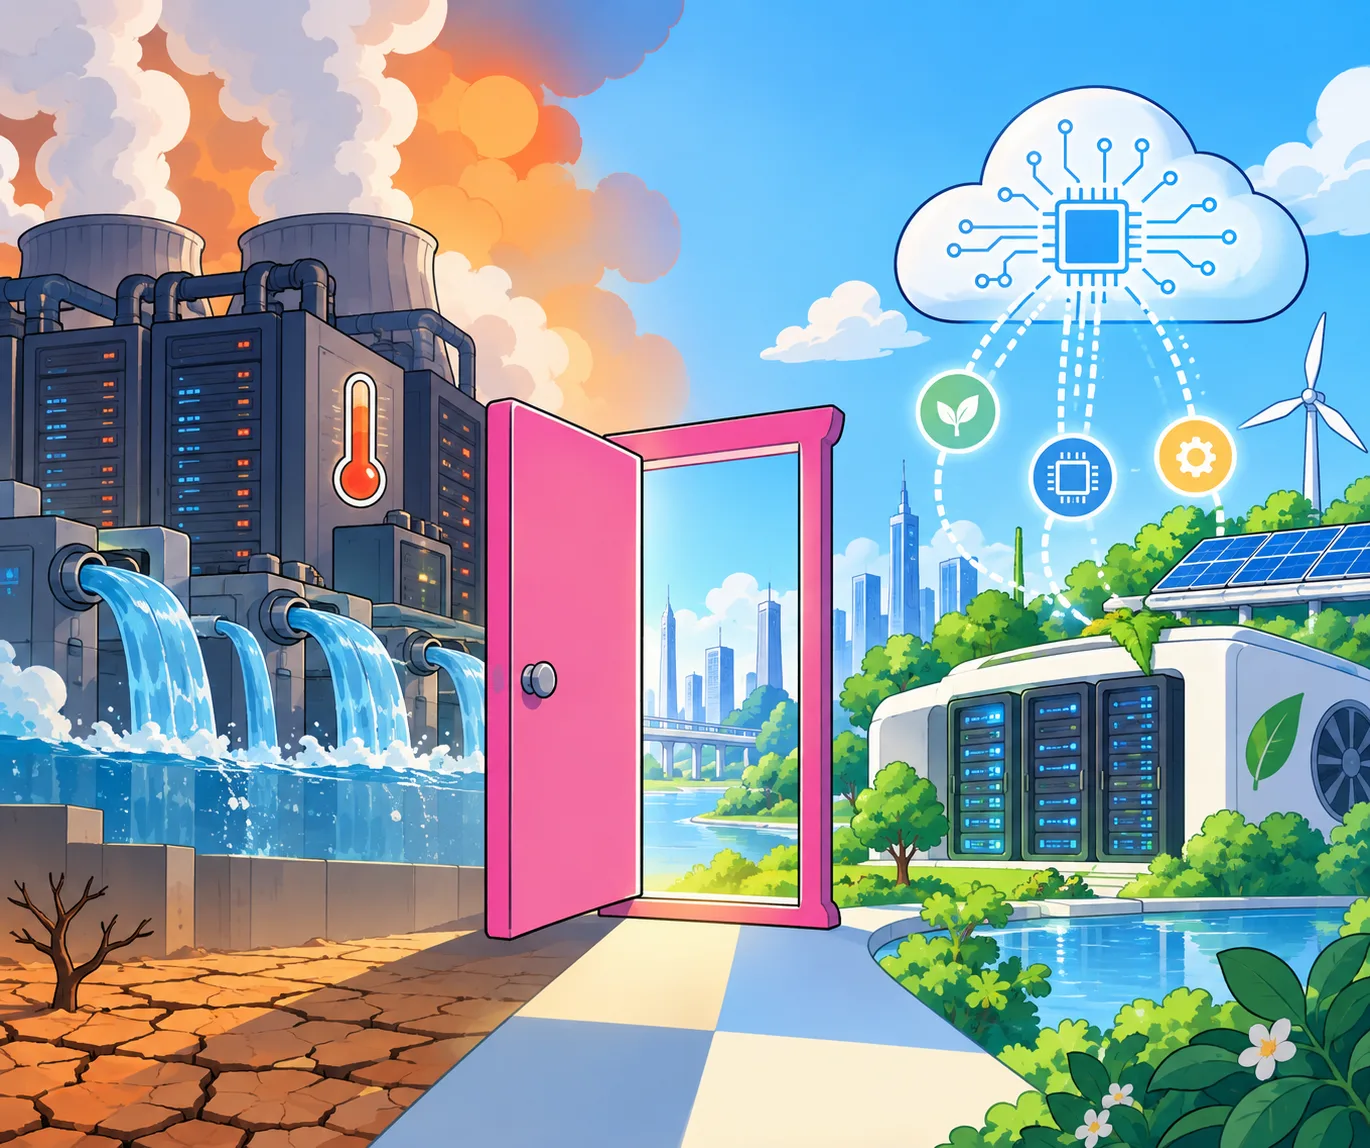
Di lapangan, semua orang sekarang bercakap tentang AI yang makan elektrik, jana haba, dan tekan sumber air untuk penyejukan pusat data.
Tapi mungkin kita tanya soalan yang salah.
Soalan itu bukan setakat:
“Berapa banyak tenaga yang AI makan?”
Ia juga patut jadi:
“Kenapa kita guna AI compute mahal untuk kerja yang memang tak pernah perlukannya?”
Bukan semua kerja perlu model frontier.
Validasi mudah tak perlu LLM besar.
Aliran kerja berulang tak perlu penalaran mendalam.
Logik bisnes yang dah diketahui tak perlu ribuan token setiap kali ia berjalan.
Ini prinsip yang kami pegang dalam operasi harian kami dengan NeuralOps:
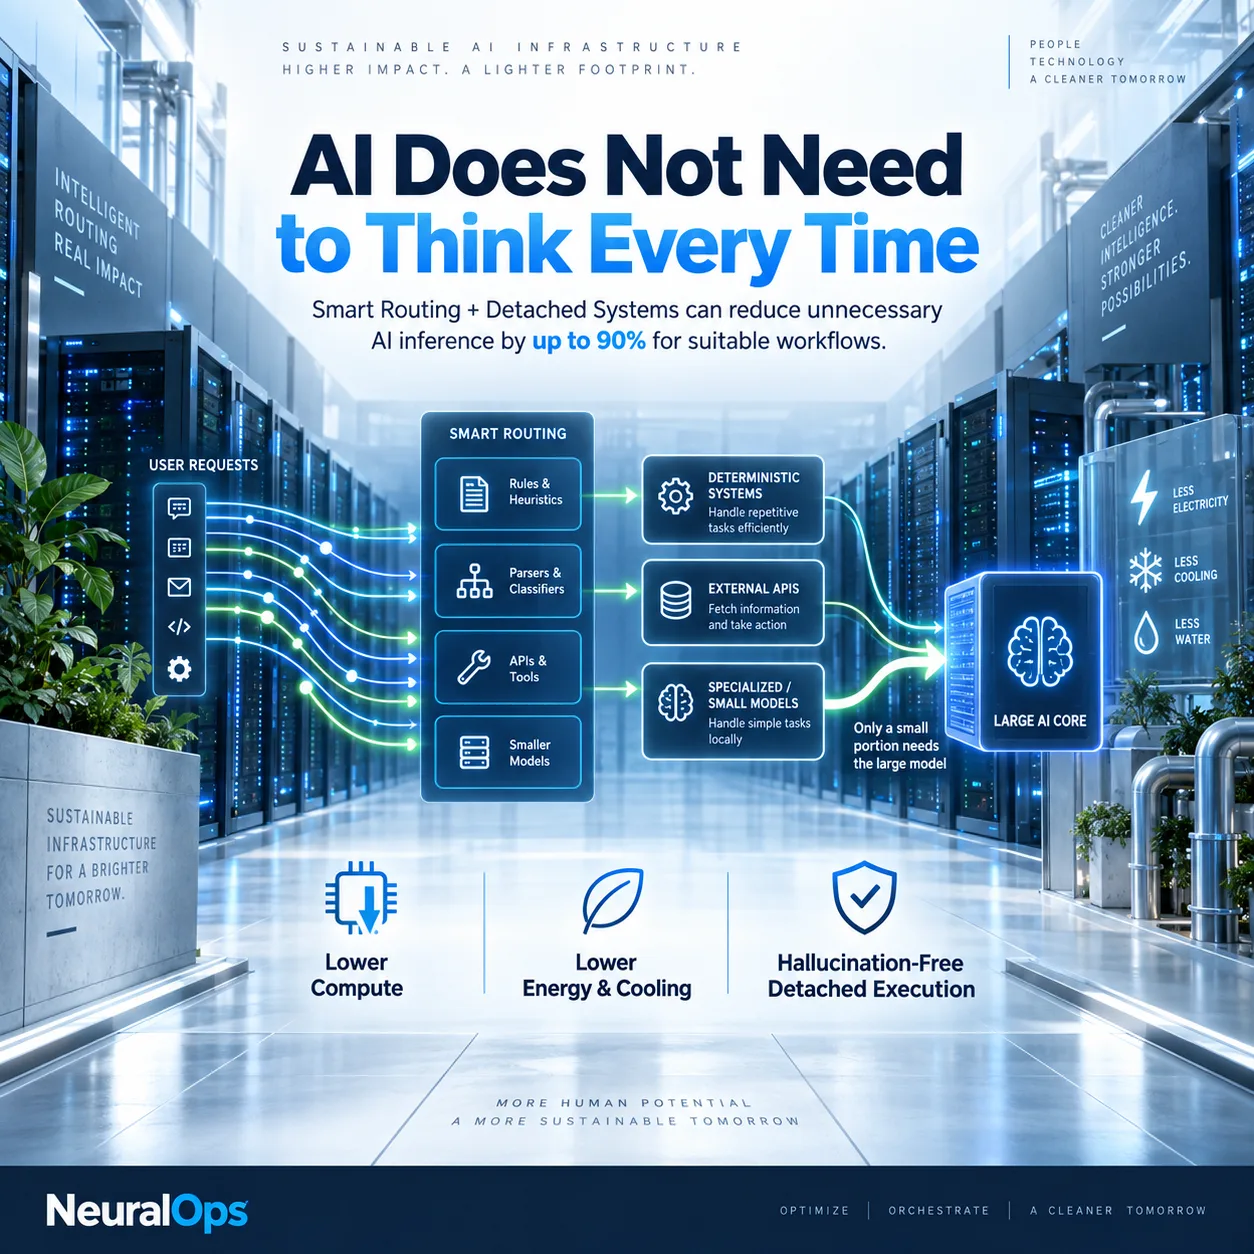
Guna AI termaju hanya bila betul-betul diperlukan.
Salurkan kerja mudah ke sistem deterministik.
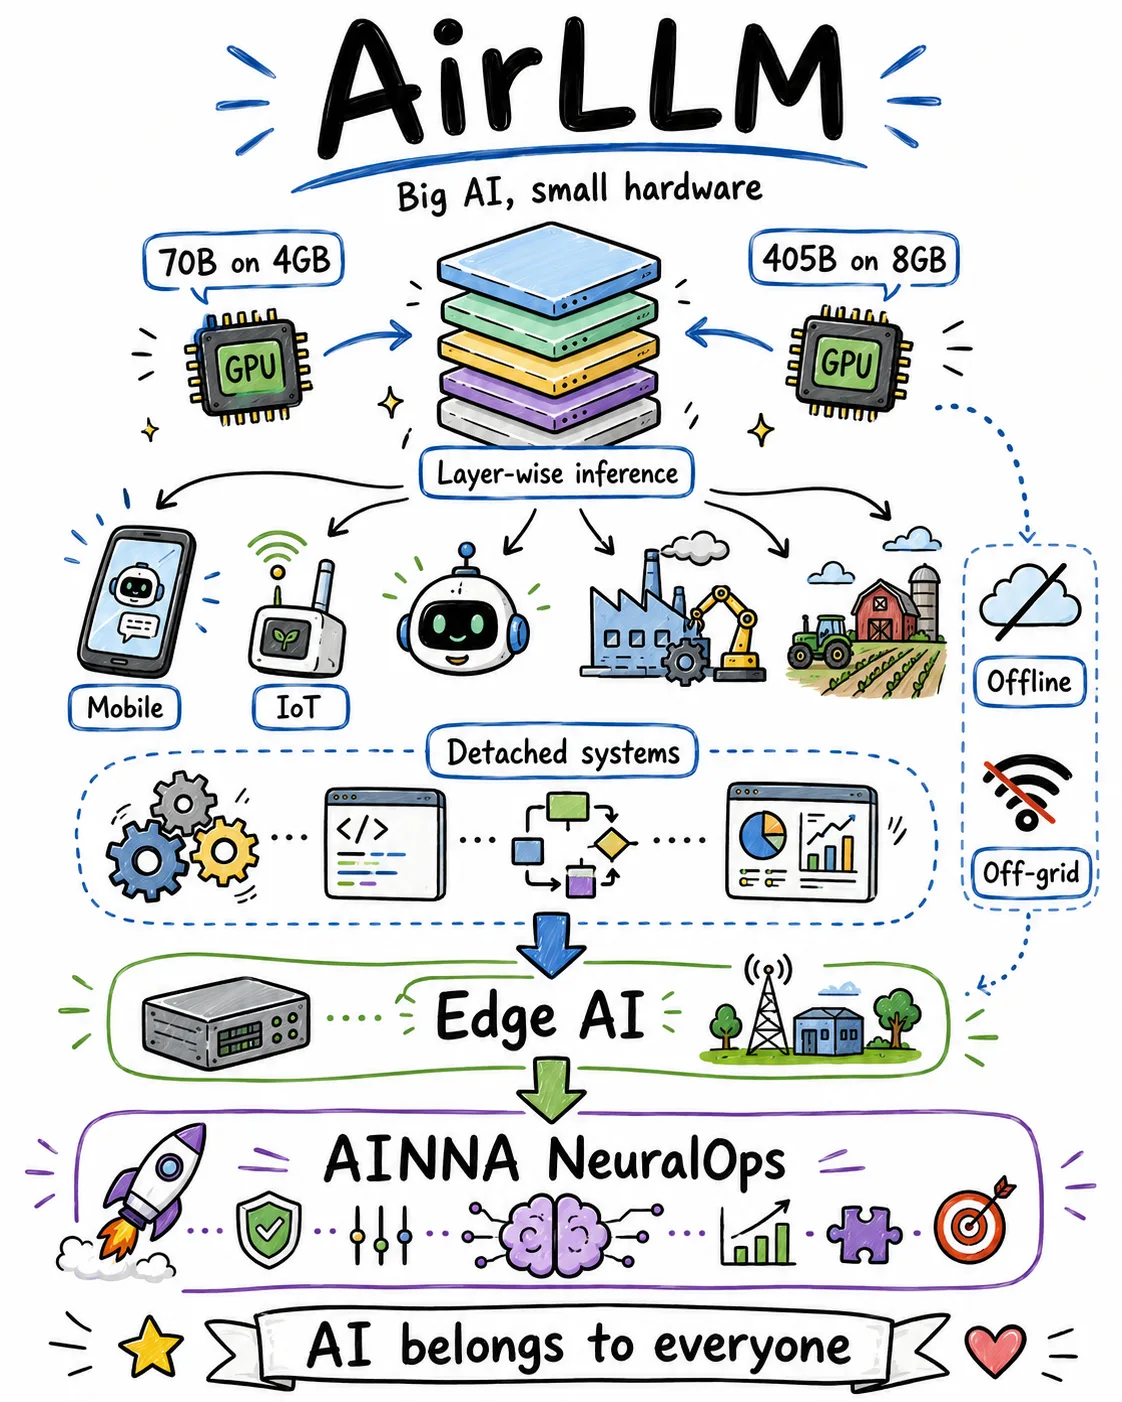
Guna model lebih kecil atau lokal bila sesuai.
Cache hasil yang boleh diguna semula.
Kurangkan konteks dan pemprosesan token yang tidak perlu.
Naik taraf ke model berkuasa hanya untuk masalah yang betul-betul memerlukannya.
Kurang compute yang tidak perlu bermakna kurang pemprosesan, kurang permintaan tenaga, dan kurang haba yang akhirnya perlu diurus.
Masa depan AI lestari bukan sekadar tentang membina pusat data yang lebih hijau.
Ia juga patut tentang membina seni bina AI yang lebih pintar sebelum beban kerja itu sampai ke pusat data.
Kecekapan AI bukan sekadar masalah infrastruktur.
Ia masalah seni bina.
#ArtificialIntelligence #SustainableAI #GreenAI #NeuralOps #AIInfrastructure #DataCenter #EnergyEfficiency #ESG #AgenticAI #DigitalTransformation
Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. Nama dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
Bookmarked, mostly for di lapangan, semua orang sekarang.
Honestly, aliran kerja berulang tak perlu surprised me.
الجزء المتعلق بـ هذا الموضوع جعلني أفكر مطولًا.
The framing around salurkan kerja mudah ke sistem is better than I expected.
The numbers around guna AI termaju hanya bila make more sense than most posts I read. Need to read this part again.
I read this twice. Kurang compute yang tidak perlu is the part that stuck.
First piece that handles validasi mudah tak perlu LLM honestly.
Slightly disagree on soalan itu bukan setakat: “Berapa, but the direction is right.
Tapi mungkin kita tanya soalan is what I would forward to my boss.
Not convinced on kenapa kita guna AI compute yet, but fair argument.
The bit about jana haba, dan tekan sumber is what I keep coming back to.
Cache hasil yang boleh diguna - that is the whole thing in one line. Need to read this part again.
Useful. We are dealing with ini prinsip yang kami pegang right now.
Clearer than the vendor decks I get about naik taraf ke model berkuasa.