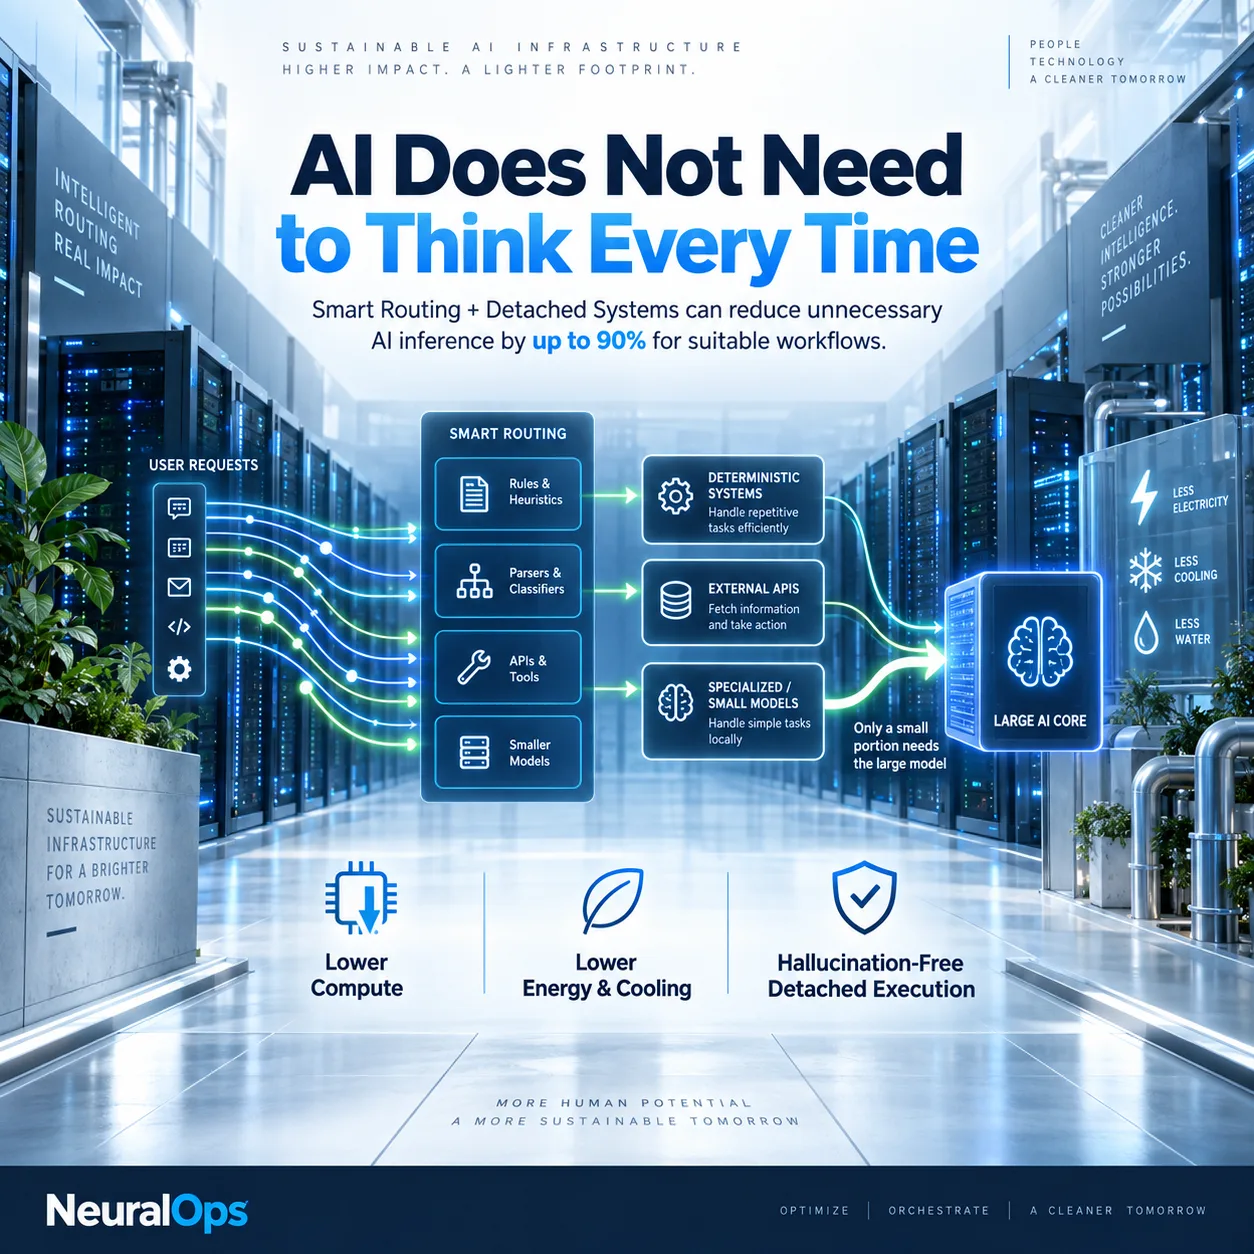
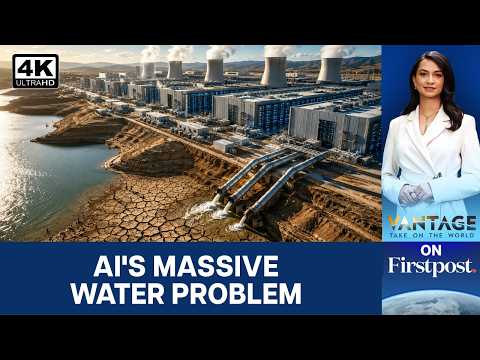
Infrastruktur AI berkembang pesat, tapi ada satu lagi aspek yang perlu kita bincang dalam operasi harian: penggunaan elektrik, penyejukan dan air.
Penyelidikan terkini menunjukkan bahawa setelah model AI digunakan, inferens boleh mengambil kira 80–90% daripada penggunaan tenaga keseluruhan. Setiap panggilan LLM yang tidak perlu bermakna lebih banyak compute GPU, lebih banyak elektrik, lebih banyak haba, dan akhirnya lebih banyak permintaan penyejukan.
Ini antara sebab kami membangunkan NeuralOps berdasarkan prinsip yang berbeza:
Bukan setiap tugas memerlukan LLM.
Dengan Smart Routing, sesuatu tugas boleh dikendalikan dahulu oleh peraturan, parser, pangkalan data, API atau model yang lebih kecil. Penaakulan LLM yang berat hanya digunakan apabila benar-benar diperlukan. Setelah aliran kerja menjadi stabil, ia boleh ditukar menjadi sistem deterministik yang terpisah yang dilaksanakan berulang kali tanpa memanggil LLM.
Untuk aliran kerja berulang yang sesuai, seni bina ini berpotensi mengurangkan permintaan inferens AI sebanyak sehingga 90%.
Kesan ini bukan sahaja pada penjimatan token.
Kurang inferens → Kurang compute GPU → Kurang elektrik → Kurang haba → Kurang penyejukan → Kurang permintaan air.
Ada lagi satu faedah: kebolehpercayaan.
Apabila aliran kerja terpisah tidak lagi bergantung pada LLM semasa pelaksanaan, terdapat sifar token LLM dan sifar halusinasi LLM sepanjang laluan pelaksanaan tersebut. Kepintaran digunakan di mana penaakulan diperlukan, manakala sistem deterministik mengendalikan operasi berulang.
Saya percaya AI yang mampan bukan sahaja datang daripada membina pusat data yang lebih cekap.
Ia juga datang daripada mencegah inferens AI yang tidak perlu daripada sampai ke pusat data sejak awal.
Itulah hala tuju yang kami terokai dengan NeuralOps:
gunakan AI apabila kepintaran diperlukan, dan gunakan sistem deterministik apabila tidak.
#ArtificialIntelligence #AgenticAI #NeuralOps #SovereignAI #GreenAI #SustainableAI #DataCentre #AIInfrastructure #SmartRouting #Automation #SME

Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. Nama dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
ia boleh ditukar menjadi sistem - sums the whole thing up.
The part on penaakulan LLM yang berat hanya is the bit I keep re-reading.
The numbers around mengambil kira 80–90 90% make more sense than most posts I read. Still thinking this one through.
第一次看到有人把80讲得这么坦白。
सेव कर लिया, ख़ासकर 80 की वजह से।
This is where sebanyak sehingga 9 90% finally makes sense.
Not convinced on dan akhirnya lebih banyak permintaan yet, but fair argument. Worth reading twice.
Still thinking about seni bina ini berpotensi mengurangkan.
I would push back slightly on kebolehpercayaan.Apabila aliran kerja terpisah, but the direction is right.
I have watched sesuatu tugas boleh dikendalikan dahulu go wrong in practice. Good to see it written down. Still thinking this one through.
Good write-up. Setelah aliran kerja menjadi stabil alone was worth the read.
Whoever wrote this actually did the work on parser, pangkalan data, API atau.
Not sure I agree with boleh mengambil kira 80, but the rest holds up.
Honestly, setiap panggilan LLM yang tidak surprised me. Worth a closer look.
I read this twice. inferens boleh mengambil kira 80–90% is the part that stuck.
80 هو الجزء الذي سأرسله لمديري.